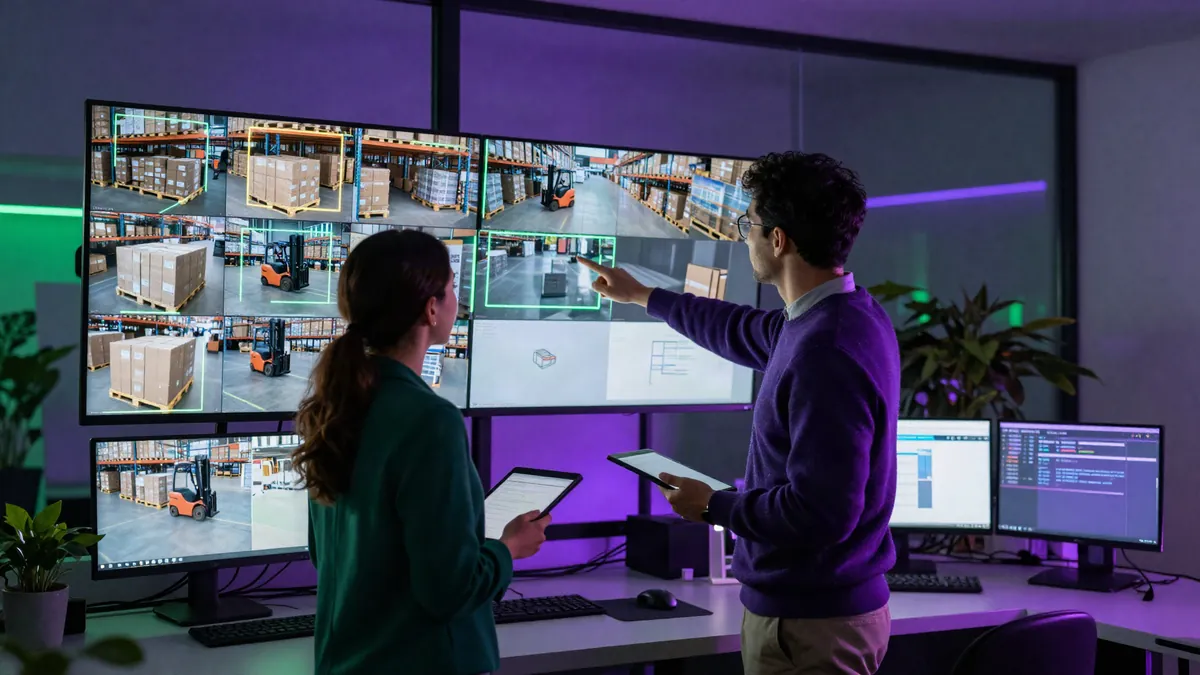
Vision AI é o uso da inteligência artificial para interpretar imagens e vídeos, identificando objetos, textos, pessoas, cenas e padrões de forma automática. A tecnologia também é chamada de visão computacional, e o mercado global desse segmento deve movimentar cerca de US$ 24,14 bilhões em 2026, chegando a US$ 72,80 bilhões até 2034, um crescimento de 14,8% ao ano, segundo a Fortune Business Insights.
O crescimento acompanha uma realidade simples: as empresas produzem cada vez mais conteúdo visual. Câmeras de segurança, fotos de produtos, documentos digitalizados, inspeções em linhas de produção e vídeos de atendimento geram um volume enorme de informação que, sem IA, fica parado.
Neste artigo, você vai entender o que é Vision AI, como a visão computacional funciona, o que ela consegue identificar e quais são as possibilidades oferecidas hoje pelo Google Cloud.
O que é Vision AI?
Vision AI, ou visão computacional, é o campo da inteligência artificial que permite a computadores e sistemas interpretar e analisar dados visuais, como imagens, documentos e vídeos, e extrair deles informações úteis. Entre as aplicações mais comuns estão a detecção de objetos, a leitura de textos em imagens, a classificação de imagens e a moderação de conteúdo.
Como a IA consegue “enxergar” e interpretar imagens?
A IA consegue enxergar porque, para um computador, toda imagem é um conjunto de números. Cada pixel tem um valor de cor e intensidade. Sozinhos, esses números não dizem nada. O que a Vision AI faz é aprender, a partir de milhões de exemplos, quais combinações de pixels formam bordas, formas, texturas e, por fim, objetos reconhecíveis.
A tecnologia ganhou relevância nos últimos anos por três motivos:
- o aumento do volume de imagens e vídeos gerados pelas empresas
- a evolução dos modelos de Deep Learning
- o acesso facilitado a esses modelos pela nuvem.
Hoje, uma empresa não precisa treinar um modelo do zero para começar. Pode usar modelos já treinados, disponíveis por APIs, e personalizá-los quando necessário.
O que é Vision AI e quem pode utilizar a tecnologia?
Vision AI é um conceito, e não um produto único. O termo descreve o conjunto de tecnologias de visão computacional capazes de transformar dados visuais em informação estruturada: uma etiqueta (“caixa”, “veículo”, “pessoa”), um texto extraído, uma contagem, um alerta. A visão computacional serve para automatizar tarefas visuais que antes dependiam do olho humano, como conferir produtos, ler documentos ou monitorar ambientes.
Empresas de qualquer porte podem usar Vision AI. Times de tecnologia integram a visão computacional a sistemas por meio de APIs, enquanto áreas de negócio se beneficiam dos resultados em processos como logística, atendimento, qualidade e segurança. O ponto de partida costuma ser um problema concreto, como reduzir o tempo de conferência de mercadorias ou digitalizar documentos em escala.
Como funciona o Vision AI?
O funcionamento do Vision AI segue cinco etapas, do envio da imagem até a geração de informação útil:
- Captura ou envio: a imagem ou o vídeo chega ao sistema, por câmera, upload ou integração
- Processamento: os dados visuais são convertidos e preparados para análise
- Identificação de padrões: o modelo reconhece características como bordas, formas, cores e texturas
- Classificação ou interpretação: o sistema decide o que está na imagem e com qual nível de confiança
- Geração de informação: o resultado vira dado estruturado, pronto para alimentar sistemas, relatórios ou alertas
Por trás desse processo estão alguns conceitos centrais. O Machine Learning permite que o modelo aprenda com exemplos. O Deep Learning, especialmente as redes neurais convolucionais, organiza a análise em camadas que vão de detalhes simples a objetos completos.
A partir daí surgem as tarefas mais conhecidas: reconhecimento de objetos, classificação de imagens, detecção de elementos e análise de vídeo.
O que o Vision AI consegue identificar?
O Vision AI consegue identificar uma grande variedade de elementos visuais. Os principais são:
- Objetos: produtos, veículos, equipamentos e itens do cotidiano, com a posição de cada um na imagem
- Pessoas e rostos: presença e posição de pessoas ou rostos (detecção, que é diferente de reconhecer quem é a pessoa)
- Textos: leitura de placas, etiquetas, notas fiscais e documentos, inclusive escritos à mão
- Padrões e características: cores predominantes, defeitos de fabricação, logotipos e pontos de referência
- Cenas: o contexto geral da imagem, como uma rua, um escritório ou um armazém
- Movimentos em vídeos: ações, trajetos e mudanças ao longo do tempo
Vale reforçar que os recursos disponíveis dependem da solução, do modelo e da configuração utilizados. A documentação da Cloud Vision API, por exemplo, deixa claro que a API detecta rostos e emoções aparentes, mas não oferece reconhecimento facial de indivíduos específicos.
Vision AI no Google Cloud: quais são as possibilidades?
O Google Cloud reúne um conjunto de soluções de visão computacional, cada uma pensada para um tipo de necessidade. Segundo a página oficial de Vision AI do Google Cloud, as principais são:
| Solução | Indicada para |
|---|---|
| Cloud Vision API | Integração rápida de recursos prontos: rotulagem de imagens, detecção de objetos, rostos e pontos de referência, leitura de texto (OCR) e moderação de conteúdo |
| Video Intelligence API | Análise de vídeos gravados ou ao vivo: objetos, cenas, ações e textos |
| Document AI | Extração de textos e dados de documentos digitalizados |
| Gemini (modelos multimodais) | Interpretação de imagens, vídeos e textos em conjunto, com respostas em linguagem natural |
A Cloud Vision API é o caminho mais direto para começar: usa modelos já treinados pelo Google e permite usar 1.000 unidades de recursos gratuitamente por mês, segundo o Google Cloud. Para necessidades específicas, os modelos podem ser treinados ou ajustados dentro do Gemini Enterprise Agent Platform, a plataforma de IA do Google Cloud que sucedeu o Vertex AI.
Uma atualização importante: a solução antes chamada Vertex AI Vision, renomeada como Gemini Enterprise Agent Platform Vision, foi descontinuada. Segundo a documentação oficial do Google Cloud, o produto entrou em descontinuação em 15 de junho de 2026 e teve o fim do suporte em 30 de setembro de 2026.
O próprio Google indica a migração para a Cloud Vision API, para o treinamento serverless da Agent Platform ou para os modelos da Agent Platform. Para quem está planejando um projeto novo de visão computacional, esses são os caminhos recomendados.
Quais são as aplicações de Vision AI nas empresas?
As aplicações de Vision AI aparecem em diversos setores. Alguns exemplos de como a visão computacional já é usada:
| Setor | Exemplo de aplicação |
|---|---|
| Varejo | Busca de produtos por imagem, organização de catálogos e análise de gôndolas |
| Indústria | Inspeção visual de qualidade e detecção de defeitos na linha de produção |
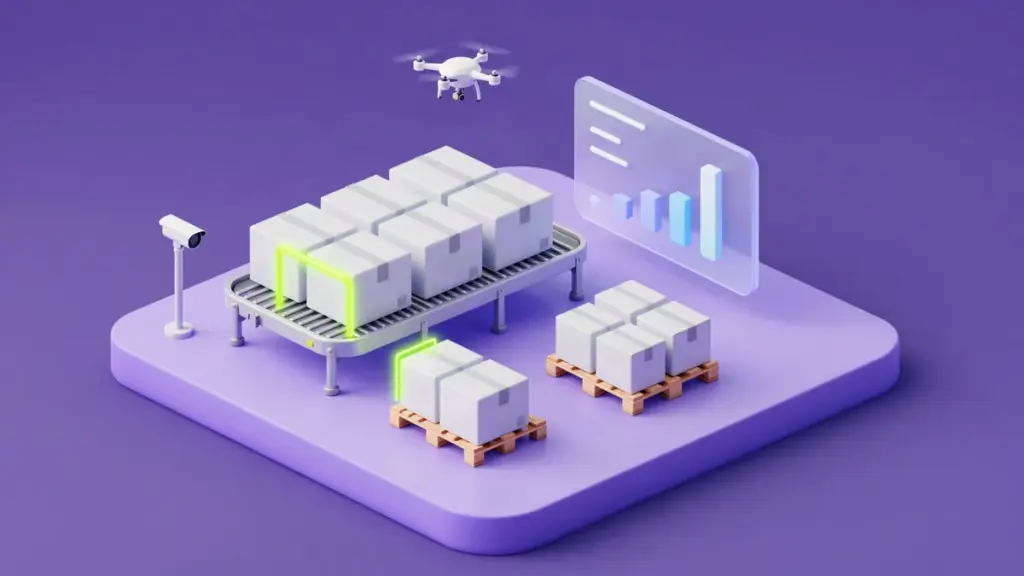
| Logística | Leitura de etiquetas, conferência de cargas e contagem de volumes |
| Segurança | Monitoramento de áreas e alertas sobre situações fora do padrão |
| Saúde | Apoio à análise de imagens e digitalização de documentos clínicos |
Na saúde brasileira, por exemplo, 18% dos estabelecimentos já utilizam inteligência artificial, percentual que chega a 29% nos Serviços de Apoio Diagnóstico e Terapêutico (SADT), onde se concentra boa parte dos exames, segundo a 12ª edição da pesquisa TIC Saúde, do Cetic.br.
Vision AI x IA generativa: qual é a diferença?
Vision AI e IA generativa são complementares, mas têm objetivos diferentes. A Vision AI interpreta o que já existe em uma imagem ou vídeo. A IA generativa cria conteúdo novo, como textos, imagens ou resumos:
| Critério | Vision AI | IA generativa |
|---|---|---|
| Objetivo | Interpretar e analisar conteúdo visual | Criar conteúdo novo |
| Entrada | Imagens, documentos e vídeos | Textos, imagens, áudios ou combinações |
| Saída | Rótulos, textos extraídos, contagens, alertas | Textos, imagens, resumos, respostas |
| Exemplo | Identificar produtos danificados em uma esteira | Gerar um relatório explicando os defeitos encontrados |
Como o Vision AI se conecta à IA multimodal?
A IA multimodal amplia o alcance do Vision AI. Modelos multimodais, como o Gemini, conseguem trabalhar com diferentes tipos de informação ao mesmo tempo: texto, imagem, vídeo e áudio. Na prática, isso significa que um sistema pode olhar uma foto de um equipamento, ler o manual técnico e responder em linguagem natural qual peça parece estar com problema.
Essa combinação entre visão computacional e modelos generativos abre novas possibilidades empresariais: atendimento que entende fotos enviadas por clientes, auditorias que cruzam imagens e documentos, e análises de vídeo que geram resumos automáticos. Para entender a base dessas tecnologias, vale ler também o nosso guia completo de Machine Learning.
Quais são os benefícios do Vision AI para empresas?
- Automação de processos visuais que antes dependiam de conferência manual
- Análise de grandes volumes de imagens e vídeos em pouco tempo
- Identificação de padrões difíceis de perceber a olho nu
- Geração de insights a partir de dados que antes ficavam parados
- Redução de tarefas manuais e repetitivas
- Monitoramento em escala, com várias câmeras ou fontes ao mesmo tempo
- Apoio à tomada de decisão com informação visual estruturada
Como garantir segurança, privacidade e governança no uso de Vision AI?
A segurança no uso de Vision AI exige atenção especial, porque imagens e vídeos podem conter dados pessoais. Pela LGPD, dados biométricos são considerados dados pessoais sensíveis, o que pede base legal específica e controles reforçados.
Os pontos principais de governança são:
- Proteção de dados e LGPD: definir finalidade, base legal e tempo de retenção das imagens
- Controle de acesso: limitar quem pode ver imagens e resultados das análises
- Armazenamento seguro: criptografia e políticas claras para guardar e descartar imagens
- Dados biométricos: cuidado redobrado com rostos e outras características que identificam pessoas
- Governança e uso responsável de IA: regras sobre onde e como a tecnologia pode ser usada
- Supervisão humana: revisão de pessoas em aplicações críticas, antes de qualquer decisão definitiva
Quais são os desafios do Vision AI?
Os desafios do Vision AI precisam entrar no planejamento desde o início. Os mais comuns são a qualidade dos dados de treinamento, a qualidade das imagens (iluminação, ângulo e resolução), a possibilidade de erros de interpretação, a necessidade de configuração adequada para cada caso, os custos de processamento em grande escala, além das questões de privacidade e governança. Por isso, a supervisão humana continua sendo essencial, principalmente em decisões que afetam pessoas.
Perguntas frequentes sobre Vision AI
Vision AI e visão computacional são a mesma coisa?
Sim, na prática os termos se referem à mesma área: a capacidade da inteligência artificial de interpretar imagens e vídeos. “Vision AI” também é o nome que o Google Cloud usa para o seu conjunto de soluções de visão computacional.
O que o Vision AI consegue reconhecer em uma imagem?
O Vision AI reconhece objetos, textos, rostos, cenas, logotipos, cores predominantes e, em vídeos, movimentos e ações. Os recursos exatos dependem da solução e da configuração escolhidas.
Qual é a diferença entre Vision AI e IA generativa?
A Vision AI interpreta conteúdo visual que já existe, gerando rótulos, textos extraídos ou alertas. A IA generativa cria conteúdo novo. As duas podem trabalhar juntas em modelos multimodais, como o Gemini.
Quais soluções de Vision AI o Google Cloud oferece?
As principais são a Cloud Vision API, a Video Intelligence API, o Document AI e os modelos multimodais Gemini, disponíveis no Gemini Enterprise Agent Platform. A antiga Vertex AI Vision foi descontinuada em 2026.
O Vision AI está de acordo com a LGPD?
A tecnologia pode ser usada em conformidade com a LGPD, desde que a empresa defina finalidade, base legal, controle de acesso e tempo de retenção das imagens. Dados biométricos são sensíveis e exigem cuidados adicionais.
Preciso treinar um modelo para começar a usar Vision AI?
Não necessariamente. APIs como a Cloud Vision API usam modelos já treinados pelo Google. O treinamento de modelos próprios só é necessário para casos muito específicos, como detectar um tipo particular de defeito.
Conclusão: Vision AI transforma imagens em informação estratégica
O Vision AI transforma imagens e vídeos em informações que podem ser usadas para automatizar processos, identificar padrões e apoiar decisões. A evolução da visão computacional, agora combinada com a IA multimodal, amplia ainda mais esse potencial. No ecossistema Google Cloud, empresas de todos os portes já têm acesso a modelos prontos e escaláveis para começar com segurança, governança e supervisão humana.
Quer descobrir como a inteligência artificial pode transformar imagens e vídeos em informações estratégicas para o seu negócio?
Continue acompanhando os conteúdos da IPNET by Vivo e explore outras possibilidades de IA e Google Cloud para transformar dados em resultados.